Politiche pubbliche basate sulla scienza con l’aiuto dell’IA
10 Novembre 2026
Una soluzione innovativa per prendere decisioni più informate, a vantaggio della società. Il software è nato dalla collaborazione tra i Centri Digital Society e IRVAPP della Fondazione Bruno Kessler di Trento, nell’ambito del progetto PolicyAId finanziato dal PNNR
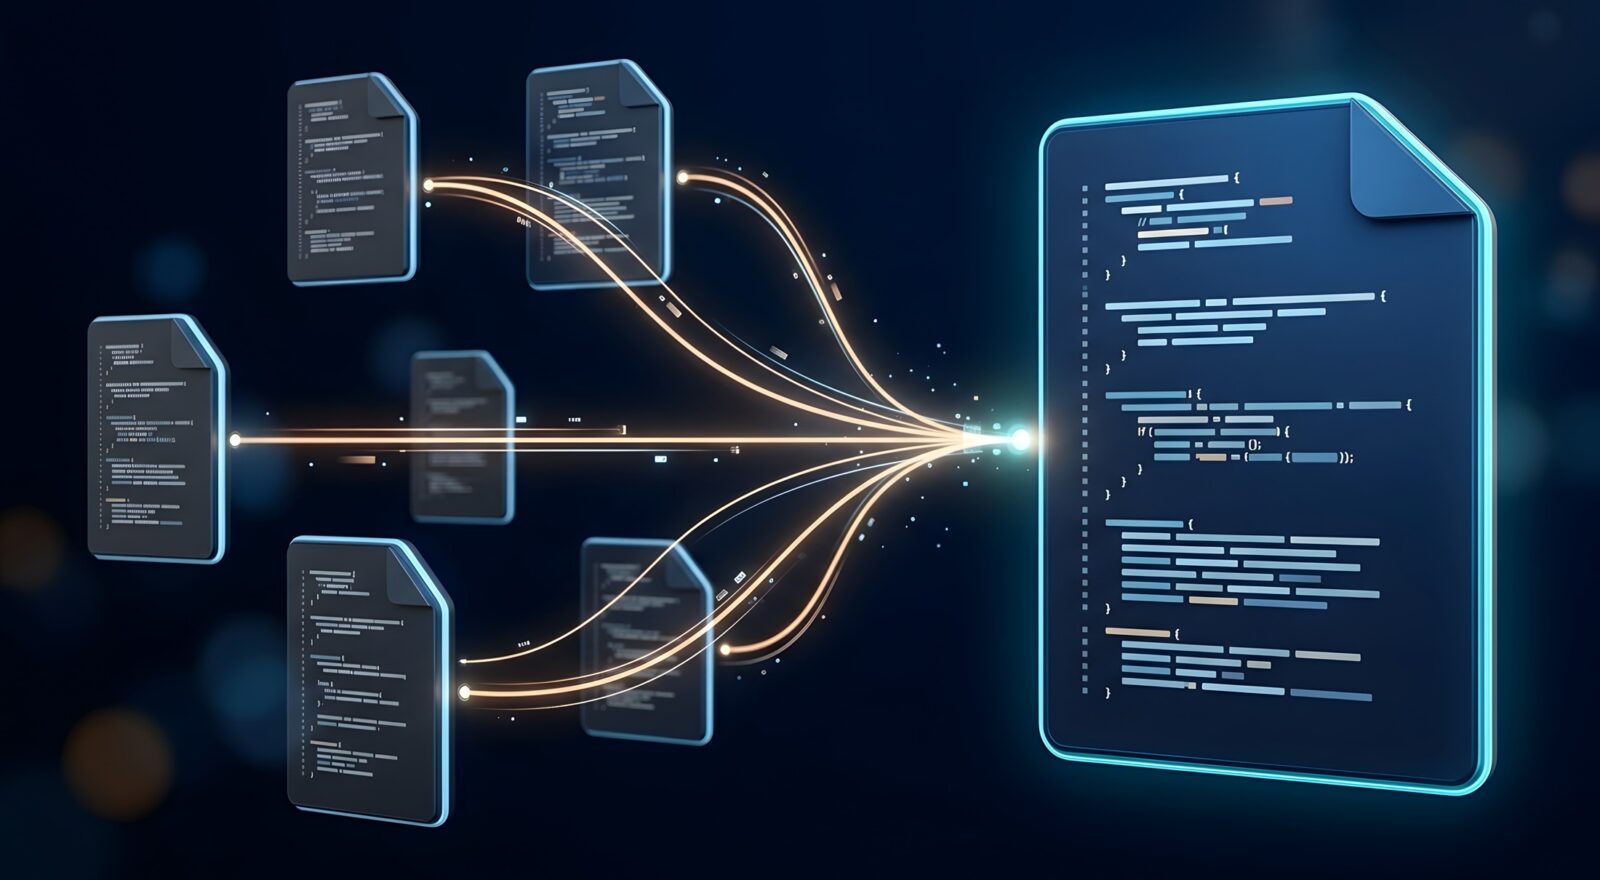
Un software a supporto di analisti esperti, basato sull’intelligenza artificiale e capace di esaminare e sintetizzare i migliori studi disponibili al mondo nell’ambito delle politiche pubbliche, per permettere ai decisori di avere informazioni utili a effettuare di volta in volta le scelte migliori possibili, a tutto vantaggio dei cittadini.
Con questo obiettivo hanno unito le rispettive competenze ricercatrici e ricercatori dei Centri Digital Society e IRVAPP (Istituto per la Ricerca Valutativa sulle Politiche Pubbliche) della Fondazione Bruno Kessler di Trento, nel corso del progetto PolicyAId finanziato dal PNNR.
“La comunità internazionale della ricerca valutativa”, spiega la ricercatrice FBK-IRVAPP Dominique Cappelletti, “ha prodotto negli anni decine di migliaia di studi di valutazione d’impatto, che misurano con rigore scientifico se un dato intervento produce gli effetti desiderati. Sappiamo, ad esempio, quali programmi di sostegno scolastico riducono la dispersione, quali politiche attive del lavoro aumentano davvero l’occupazione, quali misure di welfare hanno effetti duraturi sul benessere delle famiglie. Questo patrimonio di conoscenza potrebbe informare le scelte di chi governa. È questo il principio alla base dell’evidence-based policymaking: attingere alle più rigorose evidenze scientifiche disponibili per orientare la progettazione e la selezione delle misure più efficaci”.
Il problema principale resta l’accesso alle informazioni: la letteratura scientifica di valutazione è vasta, frammentata, pubblicata prevalentemente in inglese su migliaia di riviste accademiche, gran parte delle quali accessibile solo tramite abbonamenti. Per un decisore politico o un funzionario pubblico orientarsi in questo oceano richiede competenze tecniche specialistiche che non sempre sono disponibili. In questo caso entrano in gioco gli analisti di politiche pubbliche che devono esaminare grandi quantità di letteratura e soprattutto selezionare i contributi metodologicamente ed empiricamente più solidi. Un lavoro che richiede però molto tempo, anche diversi mesi per una singola analisi, mentre i decisori pubblici hanno spesso bisogno di risposte rapide.
“Quando per aumentare la produttività dei processi di analisi ci si rivolge ai modelli generativi del linguaggio”, sottolinea il ricercatore del Centro Digital Society FBK Marco Rovera, “si apre un ulteriore fronte critico: i modelli linguistici generativi sono strumenti molto versatili, ma non hanno accesso diretto alle fonti primarie né alle pubblicazioni scientifiche più recenti, e soprattutto non hanno accesso alle buone pratiche e all’esperienza metodologica degli esperti analisti, con esiti potenzialmente inaffidabili per decisioni ad alto impatto.”
Da questa esigenza è nato il lavoro congiunto tra ricercatori di diversi ambiti all’interno della Fondazione Bruno Kessler. Gli esperti di valutazione delle politiche pubbliche hanno tradotto il loro modo di leggere un articolo scientifico in una check list di domande specifiche per ciascuna delle categorie di metodi consolidati in letteratura mentre i ricercatori di Linguistica Computazionale hanno realizzato un sistema che traduce queste domande in una conversazione controllata con un modello del linguaggio (LLM).
“Il risultato”, spiega il ricercatore FBK-IRVAPP Sergiu Burlacu,”è un’analisi dettagliata sia del metodo utilizzato in un articolo scientifico, sia della qualità della sua applicazione nel contesto specifico. Gli analisti possono così, ad esempio, ordinare gli articoli su un tema di interesse e basare la propria analisi soltanto su quelli che offrono le evidenze più credibili e robuste. Il sistema è disegnato per supportare l’analista, senza sostituirlo, e permette di risalire alla catena di risposte che supportano la valutazione finale di un articolo”.
Accanto alla valutazione, il sistema offre all’analista strumenti come il riassunto di un singolo articolo scientifico e la creazione di un report su un tema specifico a partire da un insieme di articoli selezionati. Riassunti e report rimangono sempre modificabili dagli analisti. “Nelle nostre intenzioni”, spiega Marco Rovera, “questo design fornisce un’alternativa al modello della scatola nera che spesso caratterizza l’uso dell’intelligenza artificiale”.
Recentemente, la collaborazione ha condotto all’articolo scientifico “Research Design Tracking and Assessment for the Social Sciences”, firmato dal ricercatore Digital Society FBK Marco Rovera e dai ricercatori FBK-IRVAPP Sergiu Burlacu, Dominique Cappelletti, Alessio Tomelleri, Sonia Marzadro, Martina Bazzoli, Annalisa Tassi, Jessica Gagete-Miranda, che definisce formalmente questo compito, ne misura sistematicamente le prestazioni con diverse tecnologie e diversi modelli del linguaggio, e pone a confronto le valutazioni degli esperti con quelle del sistema di IA.
Il contributo è stato accettato e presentato all’edizione 2026 della conferenza “Empirical Methods in Natural Language Processing (EMNLP)”, svoltasi questo autunno a Budapest, una delle sedi di riferimento a livello internazionale per la comunità di Linguistica Computazionale.
“Lo strumento”, sottolinea Marco Rovera,” è oggi in uso, in funzione sperimentale, a un gruppo ristretto di analisti e policy maker, all’interno di AMELIA, la piattaforma digitale sviluppata dalla Fondazione GRINS per facilitare l’accesso all’evidenza scientifica per le politiche pubbliche”.
La ricerca è stata resa possibile grazie a un finanziamento del partenariato GRINS (Growing Resilient, INclusive and Sustainable), nell’ambito dell’Investimento 1.3 del Piano Nazionale di Ripresa e Resilienza (PNRR), finanziato dall’Unione Europea – NextGenerationEU, Missione 4 “Istruzione e Ricerca” – Componente 2 “Dalla ricerca all’impresa” del Ministero dell’Università e della Ricerca (MUR).
Autore/i
-
 Dominique Cappelletti
Ricercatrice presso FBK - IRVAPP
MAGGIORI INFORMAZIONI -
 Sergiu Burlacu
Ricercatore presso FBK-IRVAPP
MAGGIORI INFORMAZIONI
Articoli correlati